2026年09月04日
当大模型的上下文越来越长、对话轮次越来越多,"Token 的成本"正成为 AI 规模化落地最大的隐性门槛。在 2026 开放数据中心大会暨首届算博会(2026 ODX)上,翼华科技给出了自己的答案——"AI DPU 让每一个 Token 更便宜"。
01
荣获年度先锋企业
2026 ODX · 翼华科技
作为唯一一家DPU厂商,翼华科技凭借在高端算力芯片国产化、产业化落地与行业标准引领上的系统性积累,荣获“2026 ODX 年度先锋企业”。
值得注意的是,该奖项仅由中兴通讯、上海三星半导体等少数几家行业头部企业摘得。“年度先锋企业”是本届大会唯一面向企业主体设立的荣誉,评选覆盖技术实力、商业模式、业绩增长与产业生态贡献等多重硬指标——这份来自产业顶层的认可,是对翼华科技四年深耕的扎实肯定。

本届 ODX 以“开放算力生态,Token 普惠创新”为主题。在行业目光普遍聚焦 GPU 与模型本体的当下,翼华选择在网络算力与“记忆”层深耕,与“Token 普惠”的大会主题形成了直接呼应。
作为国内算力基础设施领域最具影响力的产业盛会之一,ODX 的前身是已连续举办十二届的 ODCC 开放数据中心大会,由开放数据中心委员会(ODCC)主办,累计发布 300 余项产业成果。今年大会全新升级为“开放数据中心大会暨首届算博会”双平台,超 8000 平方米展区、20+ 专题论坛,算力芯片、液冷、DPU/智能网卡、智算集群等全产业链齐聚。
“年度先锋企业”是本届大会唯一面向企业主体设立的荣誉,评选覆盖技术实力、商业模式、业绩增长与产业生态贡献等多重硬指标——这份来自产业顶层的认可,是对我们四年深耕的扎实肯定。
02
Token 为什么贵
怎么把价格打下来
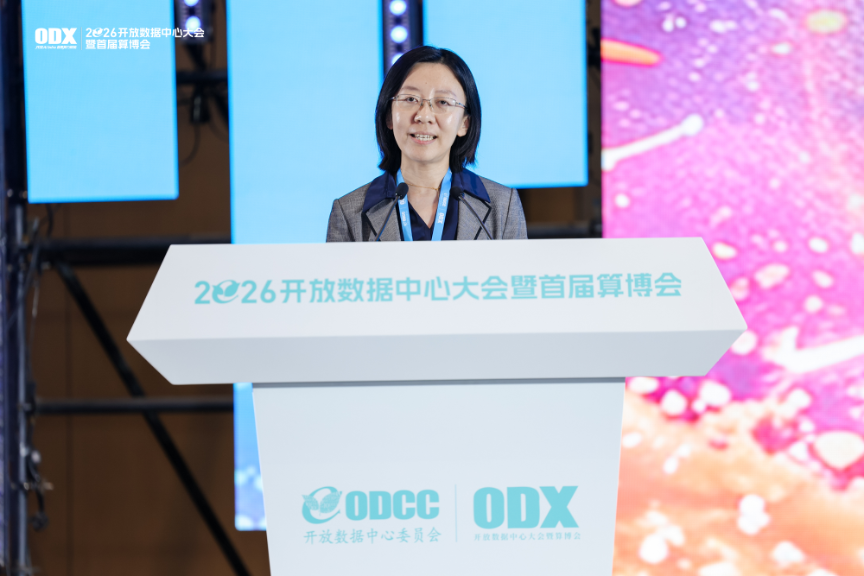
翼华科技 CTO 贾淑芸受邀参加本届大会主论坛,并发表《重构缓存边界:AI DPU 让每一个 Token 更便宜》主题演讲,核心观点有三:
其一,推理成本的瓶颈,正从"算力"转向"记忆"。
模型能力越强、上下文越长,需要“记住”的 KV Cache 就越大;一旦塞不进 GPU 显存,数据只能存放在更远的位置,每一次访问都伴随高延迟与大量重复计算——这是当前推高 Token 成本的隐形“成本墙”。
其二,破解之道在于"不重算"。
翼华带来的 DPU 驱动的 Context Memory 节点方案,即在 GPU 与通用存储之间增加一层专为 KV Cache 而生的“上下文记忆层”,实现热 KV、温 KV、冷 KV 的池化、共享与持久化;由“培风图南”AI-DPU 统一调度,将 KV Cache 从“每张卡各自为政的临时数据”,变成“全集群统一编排的共享资源”——让聊过的不重算、算过的只算一次。
其三,降本只是开始,普惠才是目的。
让 Token 更便宜,本质上是让智能真正普惠,这也是我们持续投入 AI 基础设施层的出发点。

“上下文记忆层将成为 AI 基础设施的标准一层,如同当年的 CDN 之于互联网。”贾淑芸表示,算力决定模型能想多快,记忆决定模型能想多远,而成本决定这一切能否普惠。目前,公司已开放 POC 合作计划,邀请推理框架、存储伙伴与云厂商共建开放的 Context Memory 接口标准——“带着你的真实负载来,我们一起把账算清楚。”
03
三个技术动作
让“每一个Token更便宜”落到实处
把“让 Token 更便宜”落到工程上,我们做了三件事:
极致降本:通过前缀 KV 跨请求复用与会话持久化,大幅减少重复计算,在典型场景下显著降低 Decode 阶段硬件成本与首 Token 延迟——同样的算力服务更多用户,同样的预算支撑更长的上下文。
高效卸载:AI-DPU 将 KV 索引、RDMA 零拷贝、压缩加密与智能预取等任务从 CPU/GPU 卸载,主计算全程不被打扰,数据高速流转,让最贵的算力专注最核心的计算。
开放生态:全面兼容异构 GPU、标准以太网及 vLLM、SGLang 等主流推理框架,支持存量集群平滑、渐进式升级——不推倒重来,让普惠真正接得住。
三个动作,共同指向同一个答案:AI DPU,让每一个 Token 更便宜。
04
技术积累与产业落地
让“更便宜”不只是口号
技术积累:在高端算力芯片国产化上,做系统性突破
深耕智能网卡、算力芯片全栈研发近四年,公司研发人员占比超 70%;自研 TUNAN 高性能智算网卡先后攻克原生 P4 可编程专用硬件架构、RDMA 无损网络加速、硬件级国密卸载等关键技术,自研 TUNAN 双流水线可编程芯片架构,破解了 P4 灵活可编程性与大模型高吞吐需求难以兼容的行业共性难题,产品通过信通院五星等级测评认证。相关产品经中国信通院鉴定达到国内领先水平——这是外部权威机构对公司技术实力的直接认可。
落地产业:让技术走出实验室,走向真实算力现场
公司研发的智能网卡目前已广泛部署于智算中心、大模型分布式训练集群与云数据中心,稳定承载多个算力集群的训练、推理业务;客户矩阵覆盖头部服务器厂商、AI 大模型企业、云服务商与算力运营机构。
行业引领:以标准与生态,定义国产算力的水位线
作为工信部机间互联标准工作组牵头单位,我们深度参与 RISC-V 架构、智算网络等多项国家及行业标准编制,先后斩获第二十届“中国芯”优秀技术创新产品奖、算力强基行动卓越产品、AI Cloud 典型案例等行业权威荣誉,自研算力互联核心产品及解决方案入选工信部 2025 年先进计算赋能新质生产力典型应用案例。
翼华科技一直专注于高性能网络芯片与高性能计算芯片核心技术研发,以“双芯驱动+全栈服务”模式打造国际一流算力集群。目前,图南一代 SmartNIC 已实现规模化商用出货,图南二代 SuperNIC 与培风图南 AI-DPU 在研推进中,产品已广泛落地智算中心、大模型训练集群与分布式存储等场景。
四年深耕,从一张网卡到一颗芯片,从一项标准到一个生态。让每一个 Token 更便宜,让智能真正普惠——这是翼华科技的技术主张,更是我们正在书写的答案。
